Soluciones · IA Generativa · Capacidad

Modelos multimodales

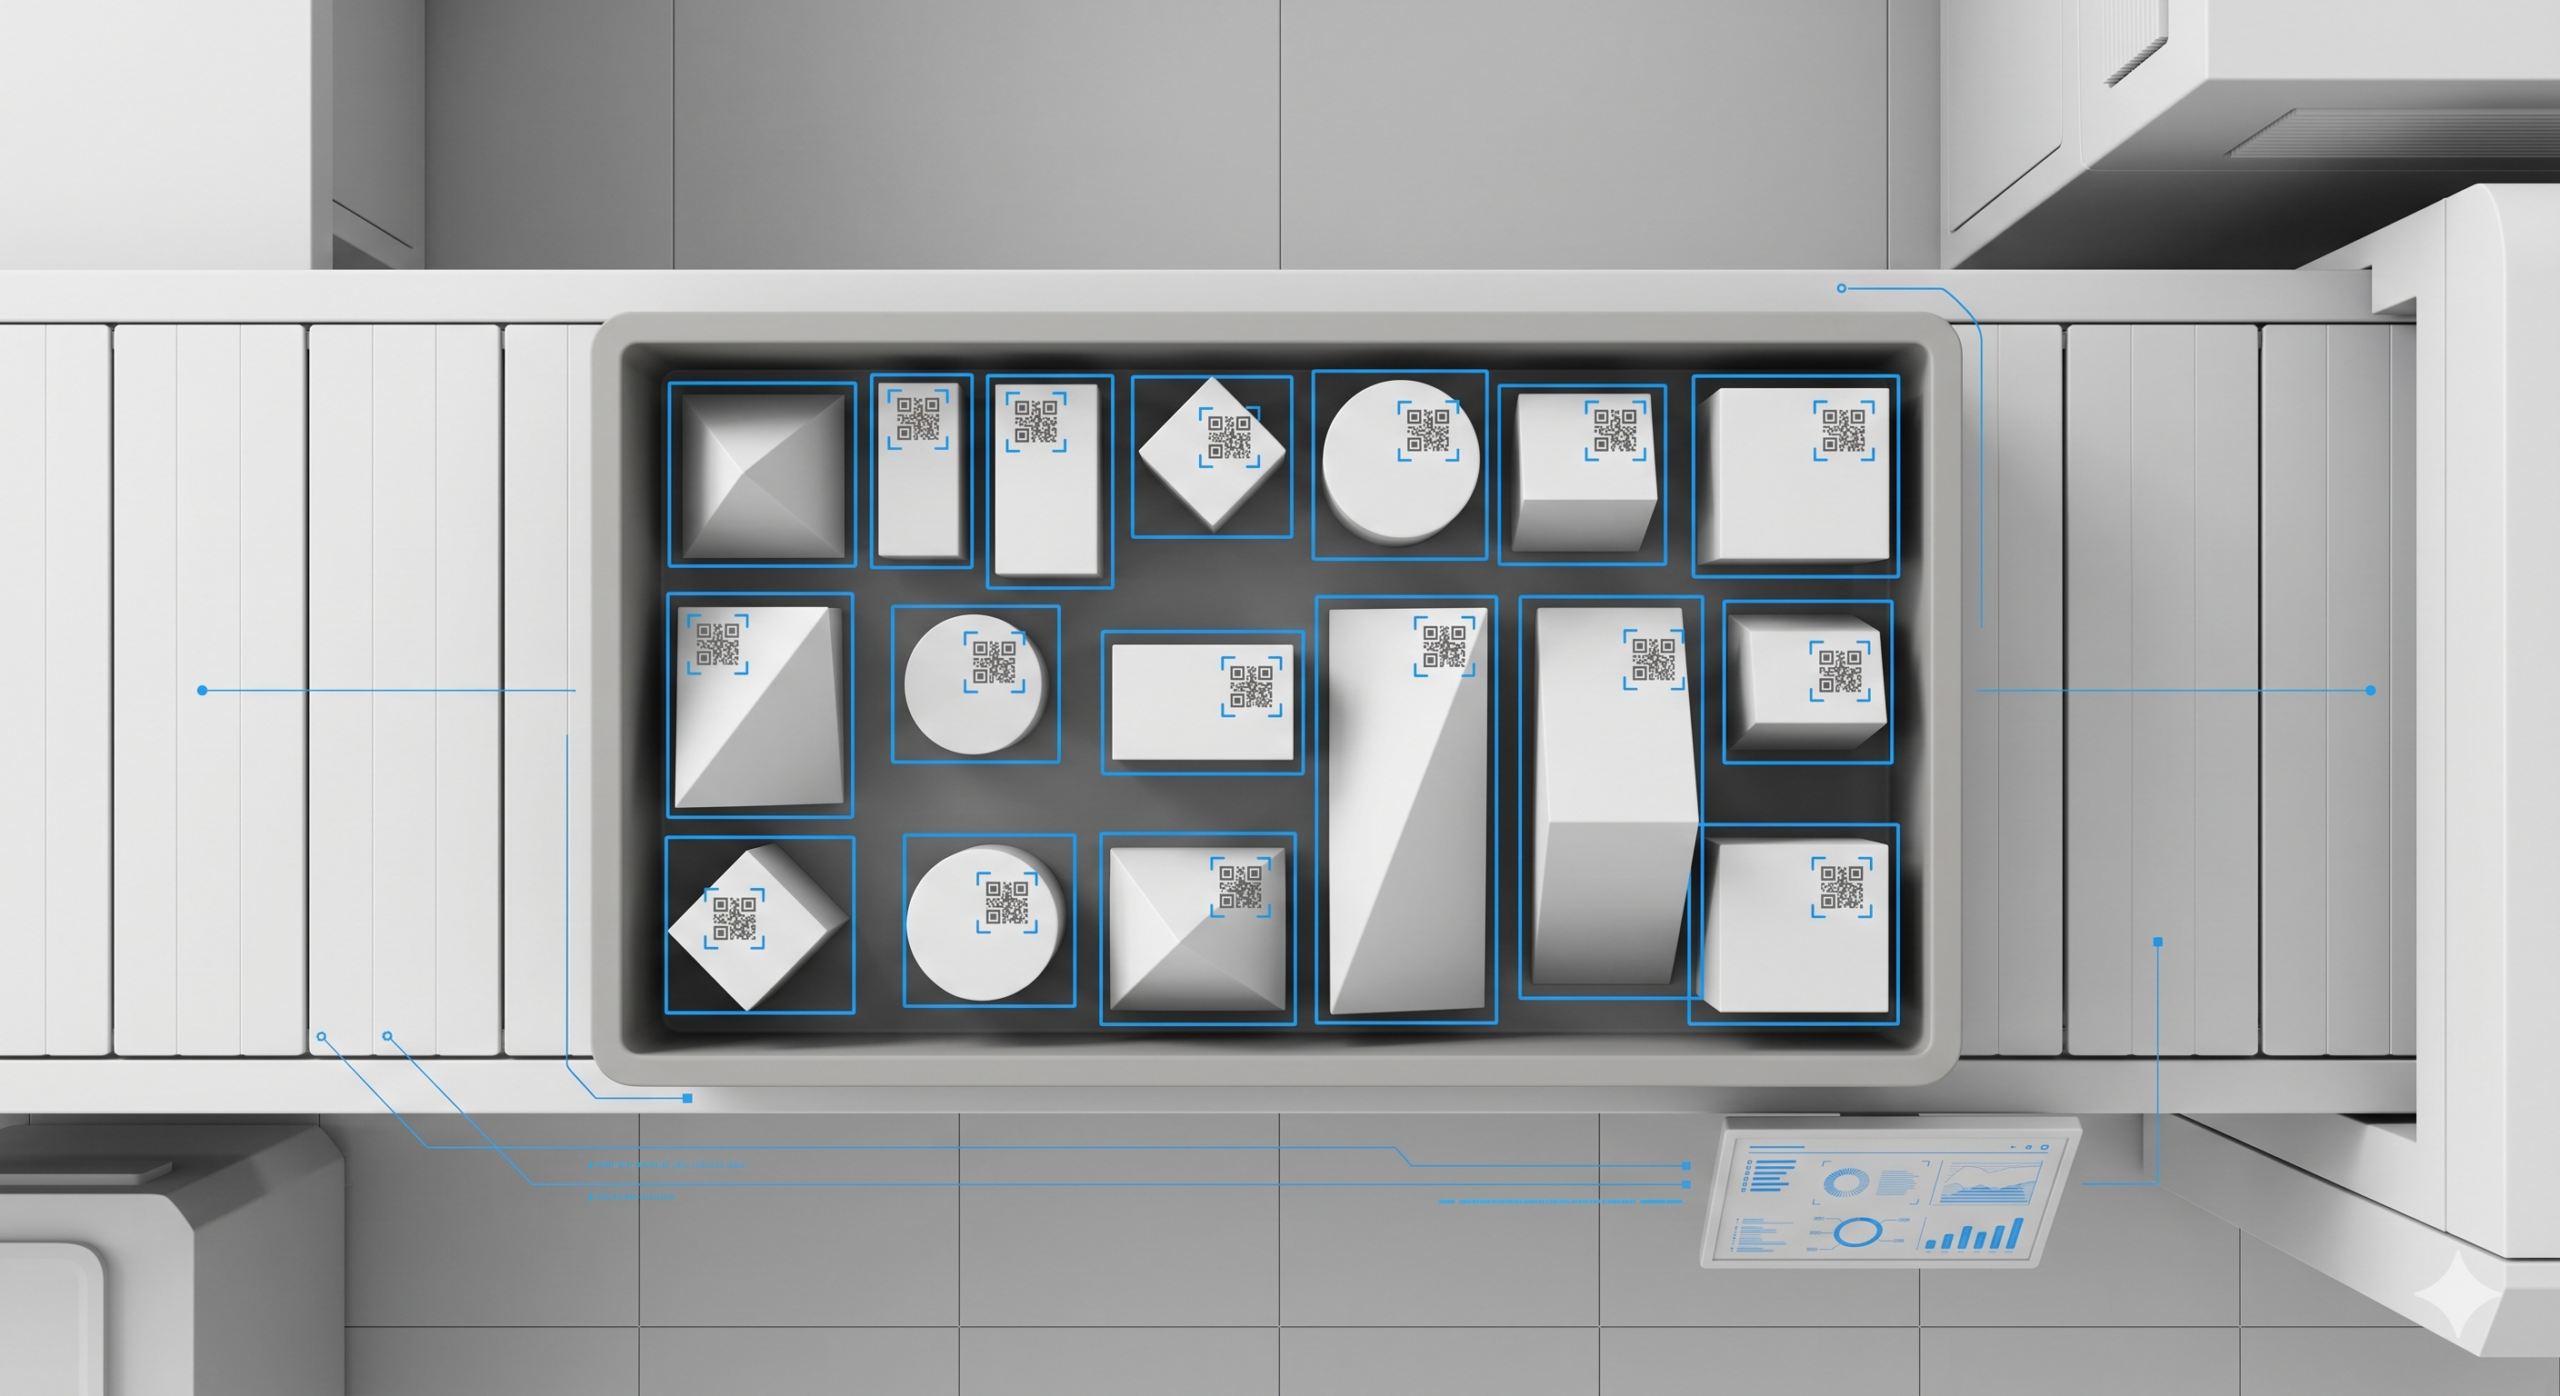
Unifique la comprensión de texto, esquemas técnicos, imágenes, video y audio en un único sistema inteligente. Diseñamos e implementamos arquitecturas multimodales que analizan activos visuales complejos junto con datos de negocio para automatizar inspecciones y decisiones multidisciplinarias.

<350 ms

Inferencia multimodal

Procesamiento simultáneo de imagen y texto en GPU local

98.8%

Precisión en diagramas y esquemas

Extracción de información técnica desde planos, blueprints y facturas

100%

Alineación cross-modal

Correlación directa entre elementos visuales y entidades de negocio

4x

Aceleración en revisión documental

Análisis automático de documentos híbridos con gráficos y tablas complejas

Sistemas textuales aislados frente a inteligencia multimodal

El límite actual
Ceguera visual en los sistemas tradicionales

Los sistemas de procesamiento de lenguaje natural convencionales no pueden interpretar planos de ingeniería, diagramas de circuitos, radiografías o videos de cámaras de seguridad, requiriendo transcripción y categorización humana propensa a errores.

Arquitectura CODE IN CO
Comprensión contextual unificada

Integramos modelos Vision-Language (VLM) de última generación adaptados a su sector, capaces de leer esquemas técnicos, inspeccionar video en vivo y cruzar hallazgos visuales con bases de datos transaccionales de forma instantánea.

Metodología de ingeniería en cuatro fases

01

Mapeo de activos multimodales
Catalogación y preprocesamiento de imágenes técnicas, planos de ingeniería, audios o secuencias de video operativas.

Entregable: Pipeline de ingesta de medios calibrado

02

Selección de arquitectura VLM
Evaluación y dimensionamiento de modelos multimodales abiertos de última generación según requisitos de precisión y latencia.

Entregable: Benchmark de arquitectura multimodal

03

Alineación y calibración de dominio
Ajuste fino de capas de proyección cross-modal para interpretar símbolos, códigos y terminología específica de su industria.

Entregable: Pesos del modelo multimodal calibrados

04

Despliegue acelerado con API unificada
Puesta en producción del motor con endpoints REST/gRPC que reciben imagen y texto, devolviendo estructuras JSON enriquecidas.

Entregable: Servicio multimodal en producción

Entregables listos para producción

Motor multimodal de análisis visual y textual

Contenedor optimizado para GPU (NVIDIA TensorRT-LLM) listo para integrarse a sus flujos de trabajo actuales.

Pipeline de extracción de información estructurada

Herramientas automatizadas para convertir planos, fichas técnicas o videos en datos relacionales listos para su ERP.

Integración cross-modal
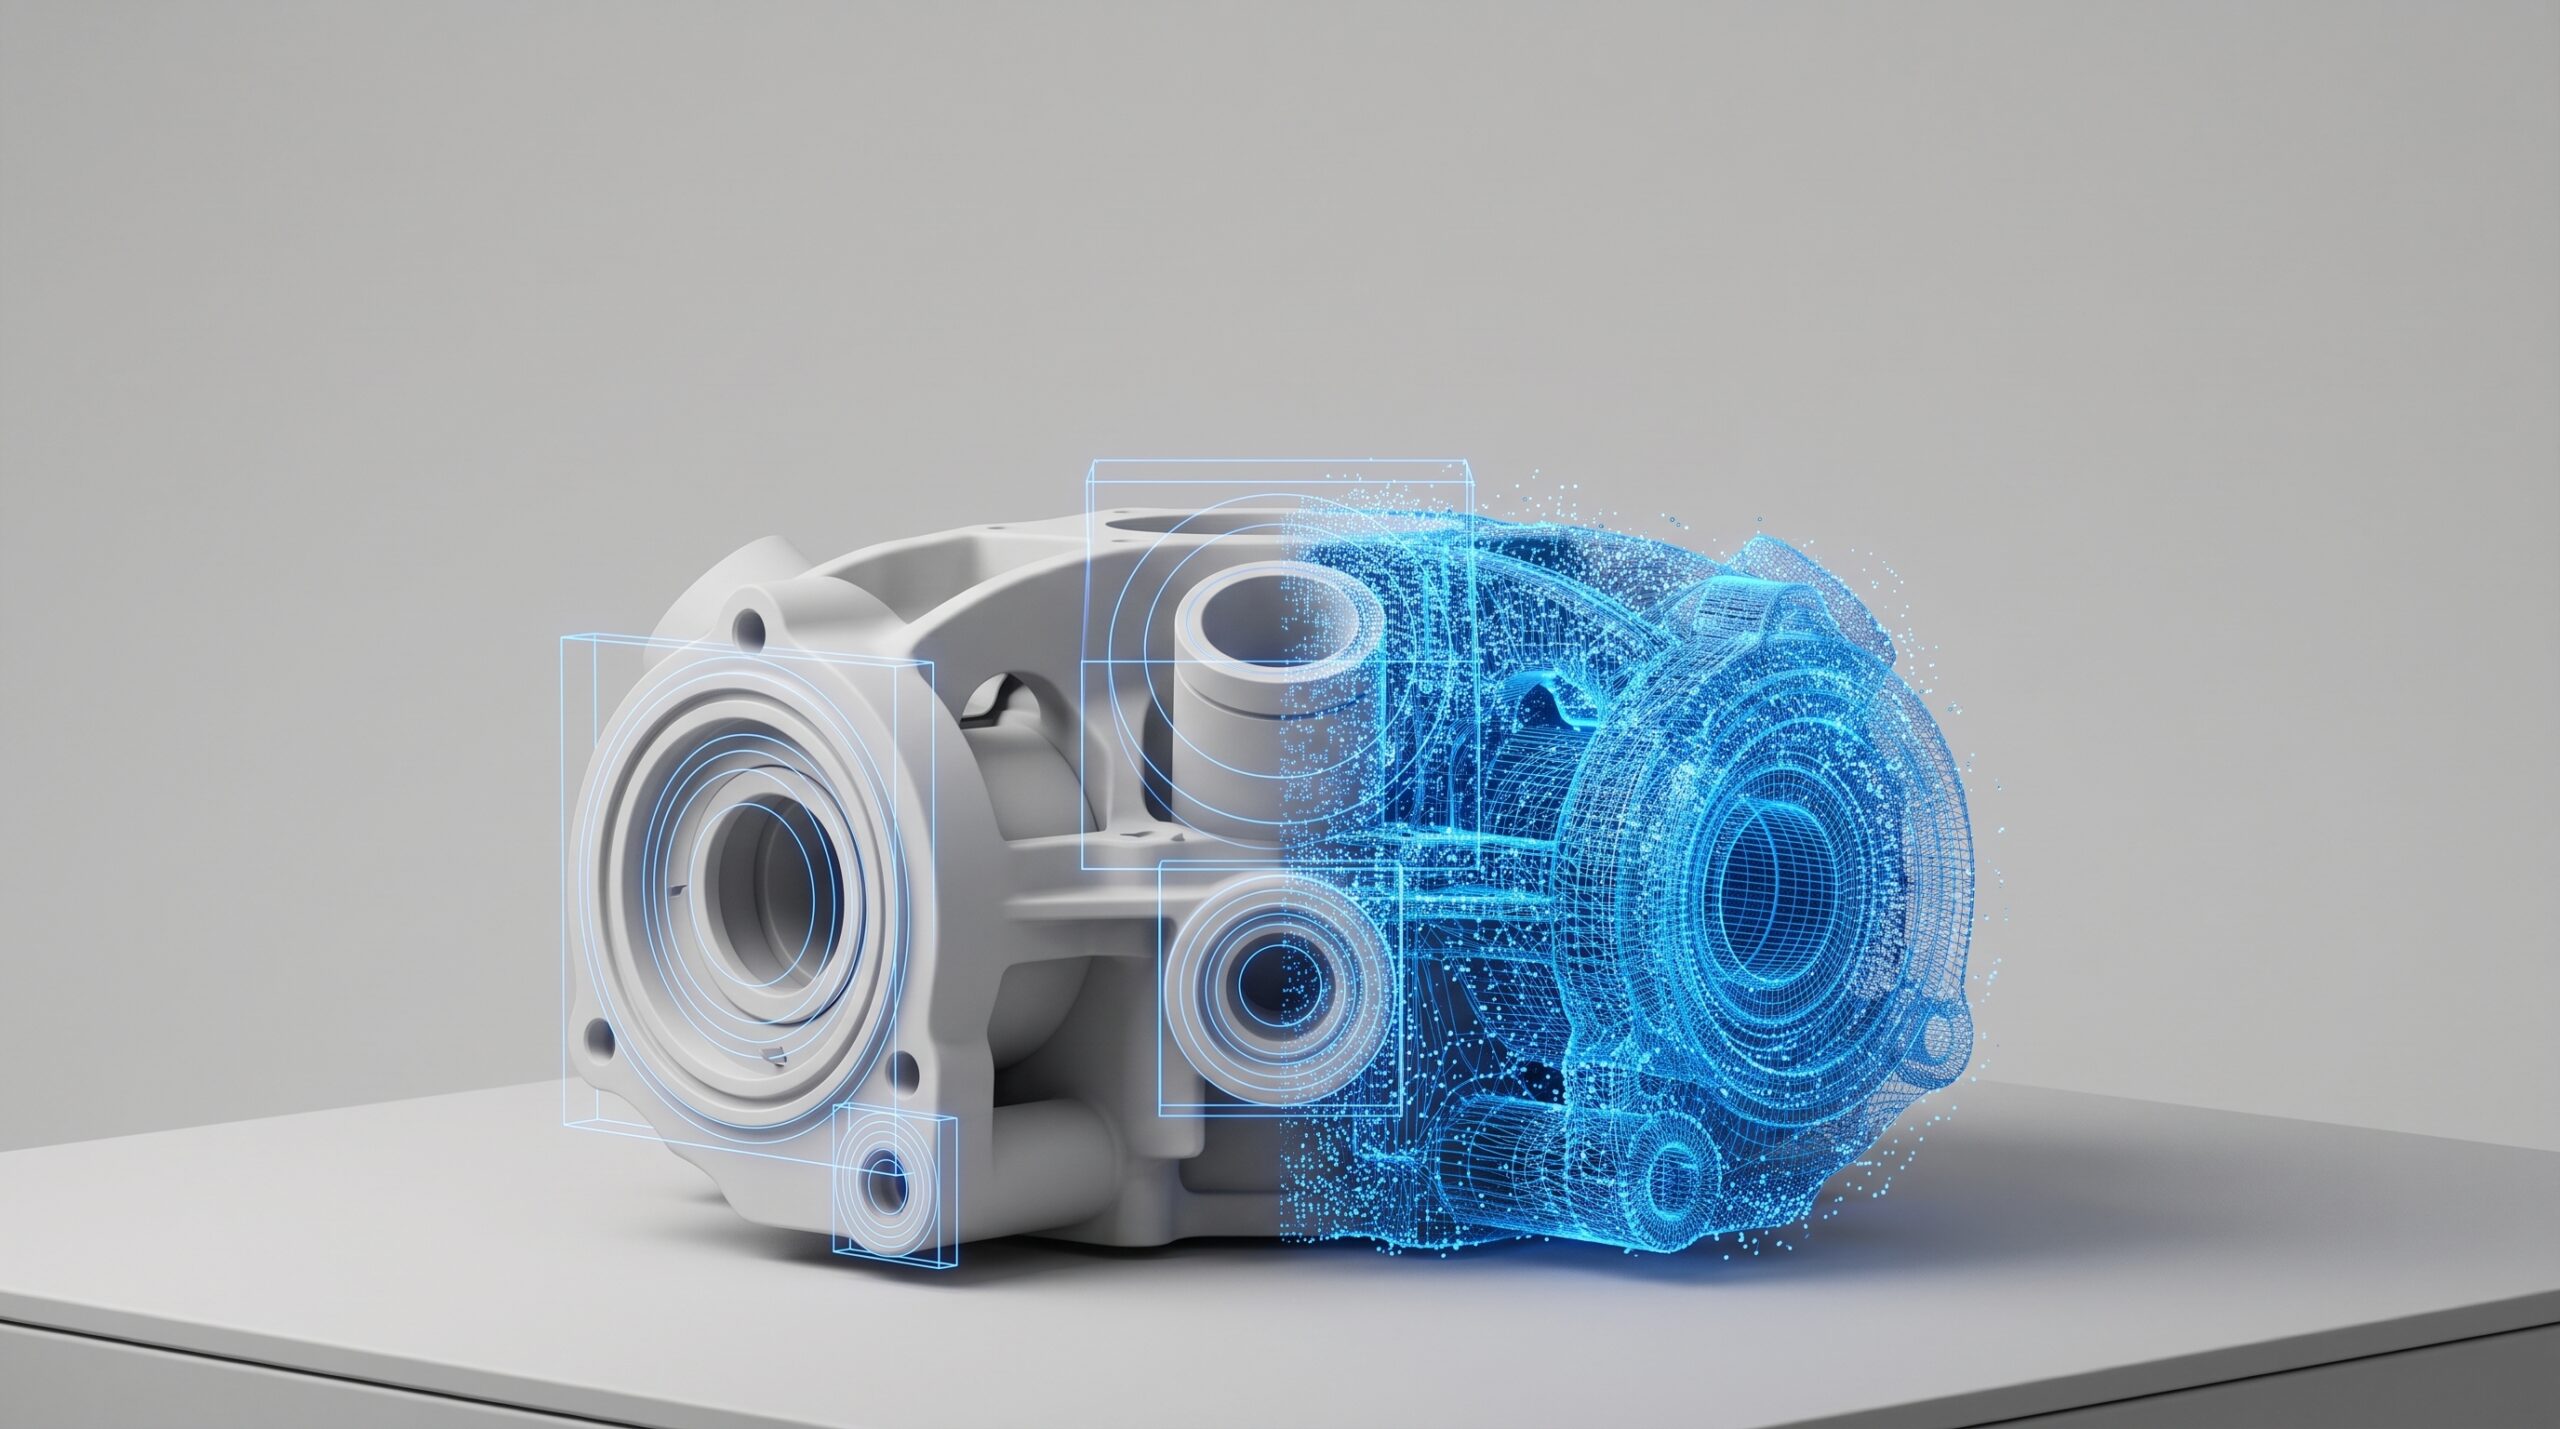
La visión artificial y el lenguaje natural conversan en una sola arquitectura

Eliminamos la barrera entre lo que se ve en la operación y lo que se registra en los sistemas corporativos.

Casos de aplicación en la industria

Ingeniería y Construcción
Auditoría automática de planos y avance de obra
Comparación de fotografías tomadas en campo contra planos BIM y esquemas estructurales para detectar discrepancias.
Seguros y Siniestros
Peritaje visual de vehículos e inmuebles
Análisis de fotografías de siniestros, estimación automática de gravedad de daños y cotejo con las cláusulas de la póliza.
Retail y Logística
Catalogación visual y búsqueda por similitud
Generación automática de descripciones ricas, etiquetado de atributos de producto y búsqueda visual a partir de fotos.
Salud y Diagnóstico
Interpretación asistida de imágenes clínicas
Lectura combinada de estudios de imagen médica (rayos X, tomografías) junto con la historia clínica del paciente.
Modelos SOTA
Integración de VLMs de código abierto
Despliegue de arquitecturas líderes adaptadas a infraestructura privada sin costos por API externa.
OCR Visual Inteligente
Extracción espacial de texto y tablas
Reconocimiento tipográfico contextual en documentos deteriorados o con diseños visuales complejos.
Análisis de Video
Procesamiento temporal de secuencias
Detección de secuencias de eventos y anomalías en transmisiones de video en tiempo real.
Optimización GPU
Cuantización y compilación TensorRT
Reducción de memoria VRAM para ejecutar modelos multimodales en hardware accesible.

¿Tiene procesos que combinan análisis visual y documental?

Descubra cómo los modelos multimodales pueden automatizar flujos complejos en su organización.