Soluciones · Analítica · Capacidad

Pipelines y data lakes (ELT)

Diseñamos e implementamos arquitecturas modernas de ingesta y almacenamiento distribuido para unificar datos dispersos en tiempo real. Construimos data lakes resilientes y pipelines ELT automatizados sobre dbt, Spark y Kafka, garantizando datos limpios, consistentes y listos para analítica avanzada.

10x

Aceleración en cargas de datos

Pipelines ELT distribuidos con paralelización nativa

99.99%

Confiabilidad operativa

Mecanismos automáticos de reintento, idempotencia y circuit breakers

<1 min

Latencia en ingesta streaming

Procesamiento de eventos en tiempo real con Apache Kafka y Spark

60%

Optimización de costos cloud

Almacenamiento en formatos columnares abiertos (Parquet / Iceberg)

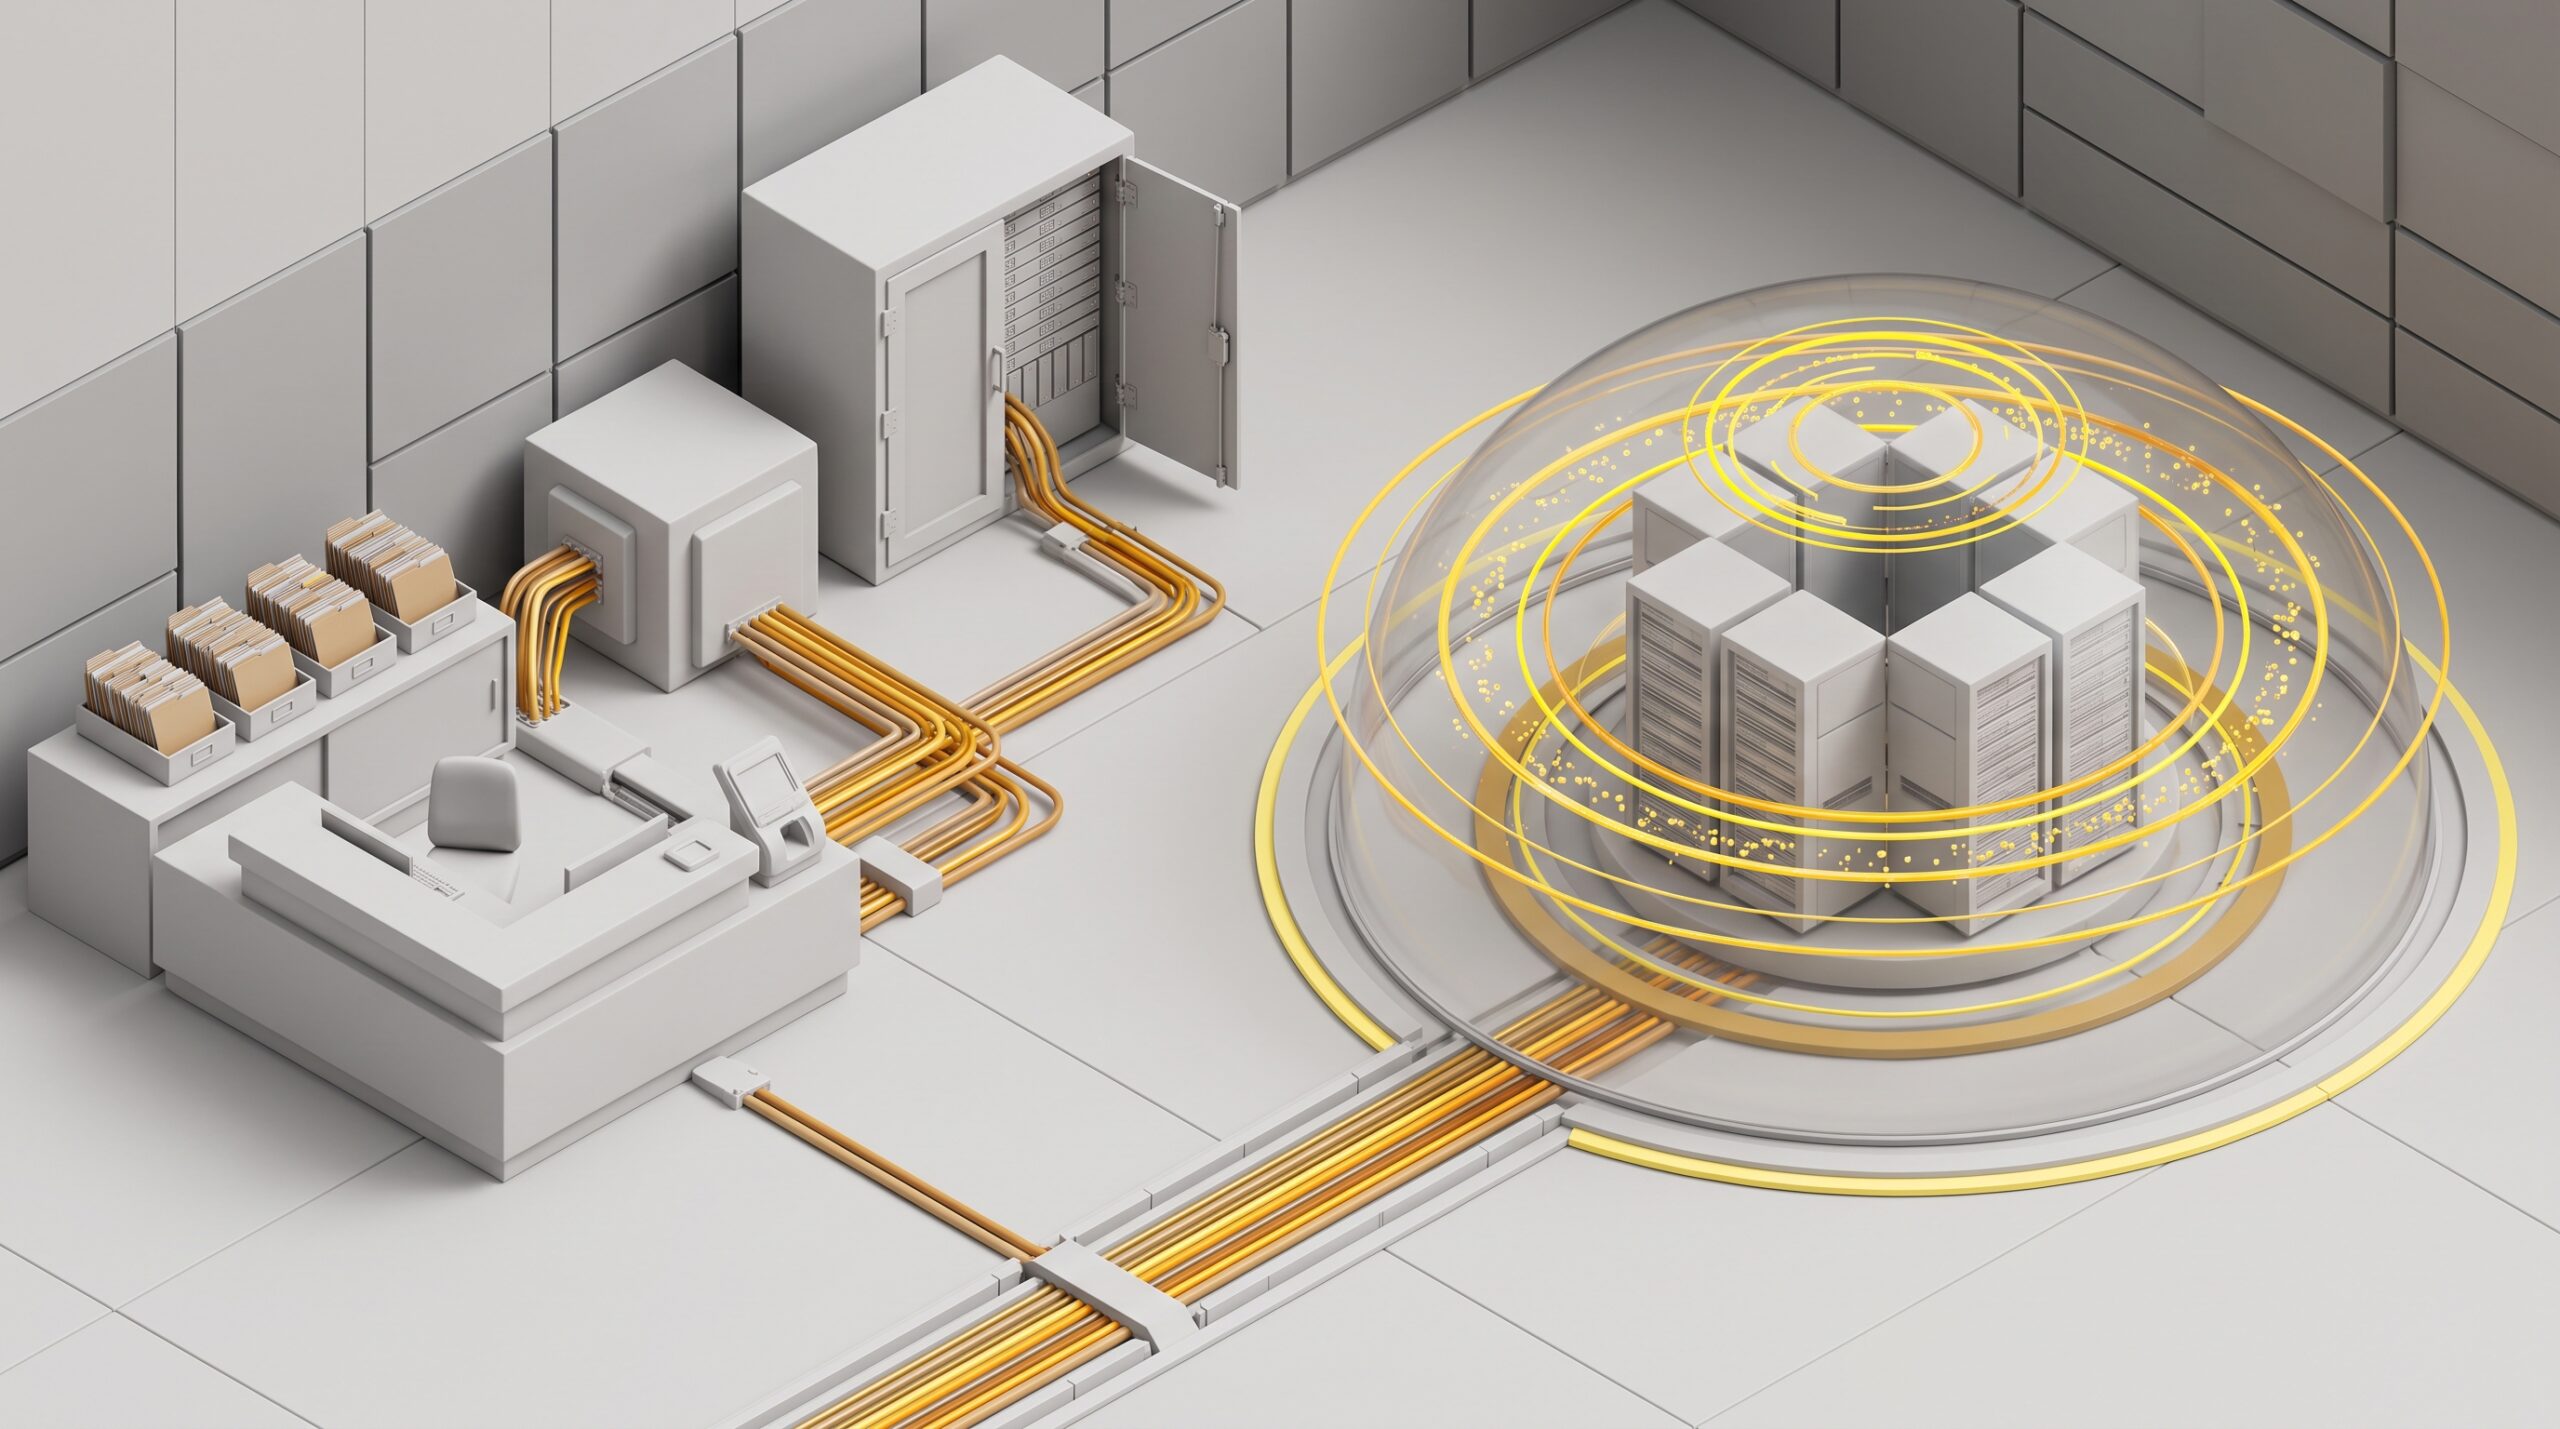
Silos de datos fragmentados frente a una arquitectura Lakehouse moderna

El límite actual
ETL monolíticos y lentitud en la toma de decisiones

Los procesos batch tradicionales tardan horas en ejecutarse, fallan frecuentemente ante cambios de esquema en bases de datos de origen y consumen presupuestos masivos en almacenamiento redundante, bloqueando la agilidad del negocio.

Arquitectura CODE IN CO
Ingesta continua y capas de refinamiento Medallion

Implementamos la arquitectura Medallion (Bronze, Silver, Gold) sobre Delta Lake o Apache Iceberg. Los datos transaccionales se ingieren en crudo, se limpian y se transforman con dbt, quedando disponibles para analistas y algoritmos sin dependencias manuales.

Metodología de ingeniería en cuatro fases

01

Descubrimiento y modelado de fuentes
Auditoría de bases de datos operacionales (Postgres, Oracle, SAP), APIs externas y flujos de eventos para definir esquemas y frecuencias.

Entregable: Matriz de fuentes y contrato de datos

02

Construcción del Data Lake y almacenamiento
Despliegue de almacenamiento columnar en la nube con formatos abiertos optimizados para consultas analíticas masivas.

Entregable: Lakehouse configurado con particionado eficiente

03

Transformación y modelado con dbt
Desarrollo de transformaciones modulares, pruebas de calidad automáticas y versionado de datos en código (DataOps) con CI/CD.

Entregable: Modelos dbt validados con tests automáticos

04

Orquestación y monitoreo continuo
Automatización del pipeline con Apache Airflow o Prefect, alertas en tiempo real por anomalías y dashboards de salud operativa.

Entregable: Pipeline en producción con observabilidad total

Entregables listos para producción

Infraestructura de Lakehouse como código (Terraform)

Plantillas reproducibles para desplegar almacenamiento, roles de acceso y conectores en su nube privada.

Repositorio de transformaciones dbt documentado

Código versionado con linaje automático de datos, pruebas unitarias y documentación generada automáticamente.

Ingeniería de datos escalable
De datos transaccionales caóticos a una fuente única de verdad corporativa

Aseguramos que cada reporte, dashboard y modelo predictivo se alimente de datos consistentes y auditables.

Casos de aplicación en la industria

Fintech y Pagos
Conciliación bancaria masiva automatizada
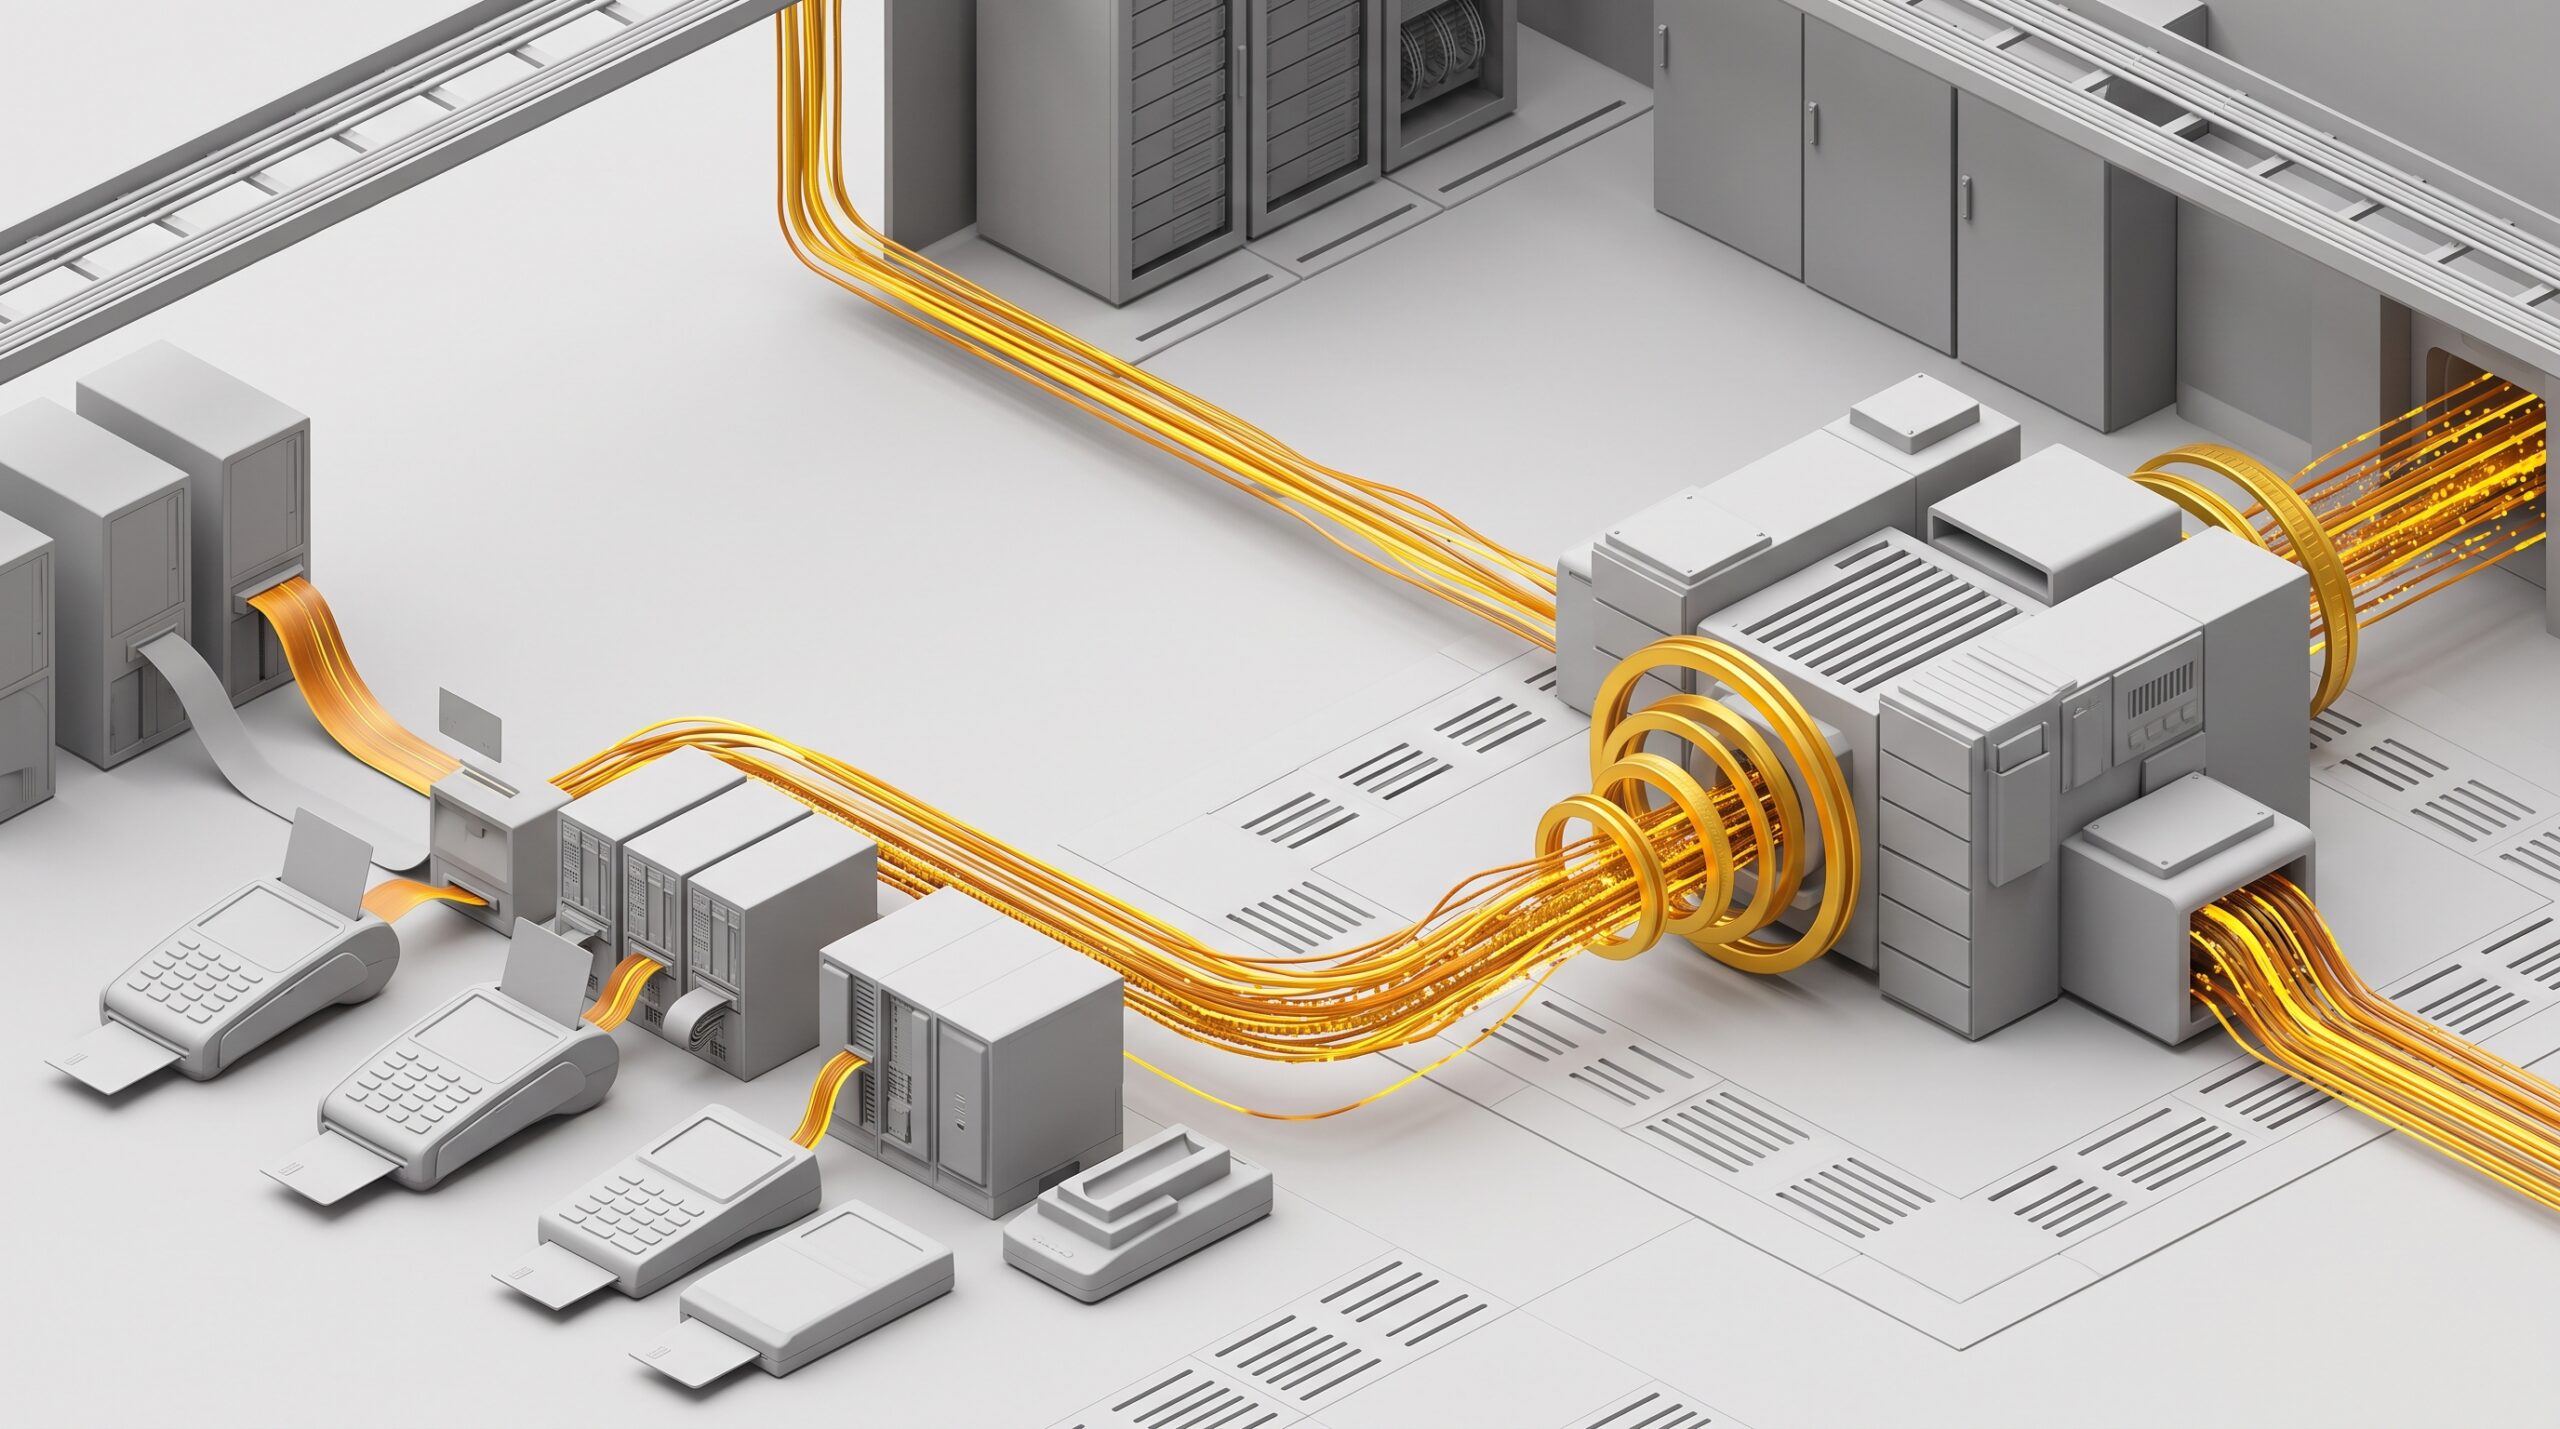
Ingesta de millones de transacciones diarias desde múltiples pasarelas y bancos para conciliación automática en minutos.
Retail y Comercio Omnicanal
Visión integral de inventario y ventas
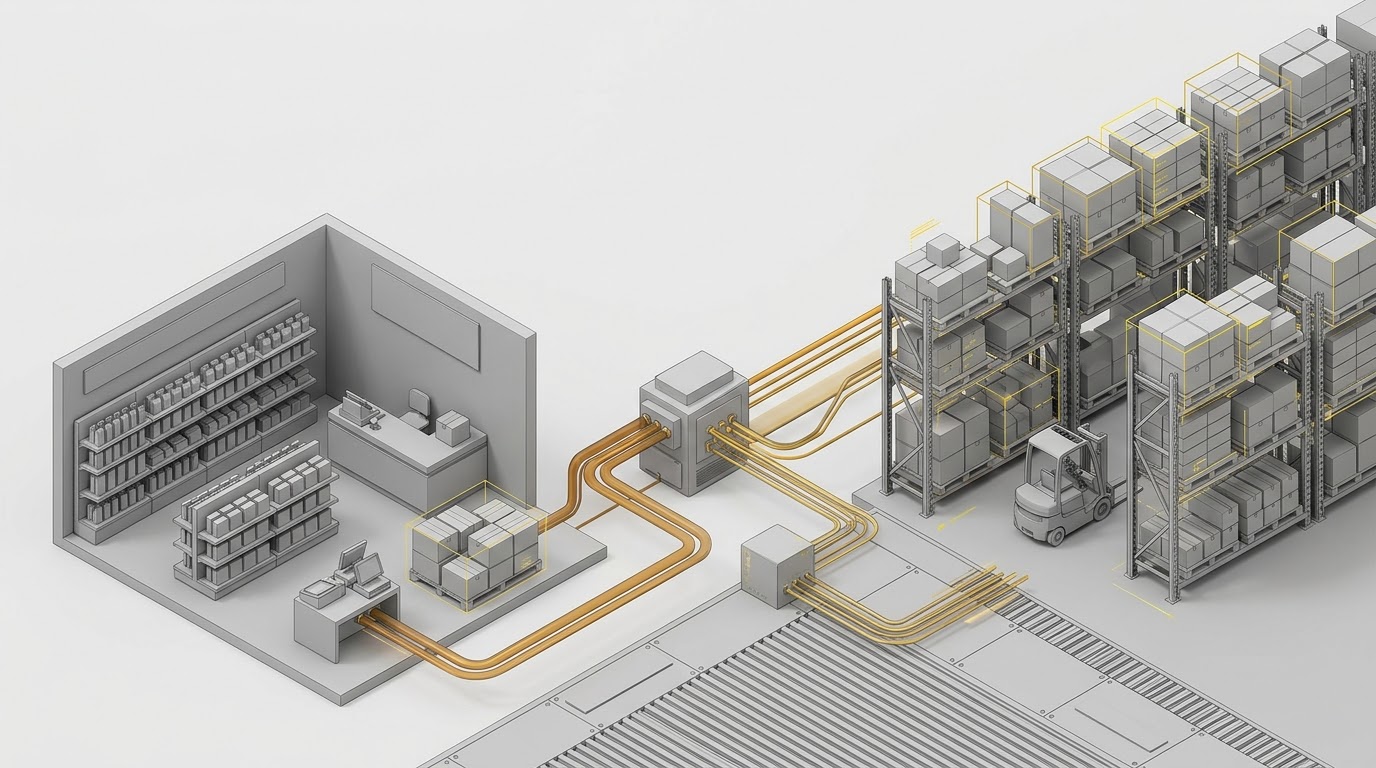
Unificación de datos de tiendas físicas, comercio electrónico y centros de distribución para optimizar abastecimiento.
Telecomunicaciones
Monitoreo de eventos y calidad de red
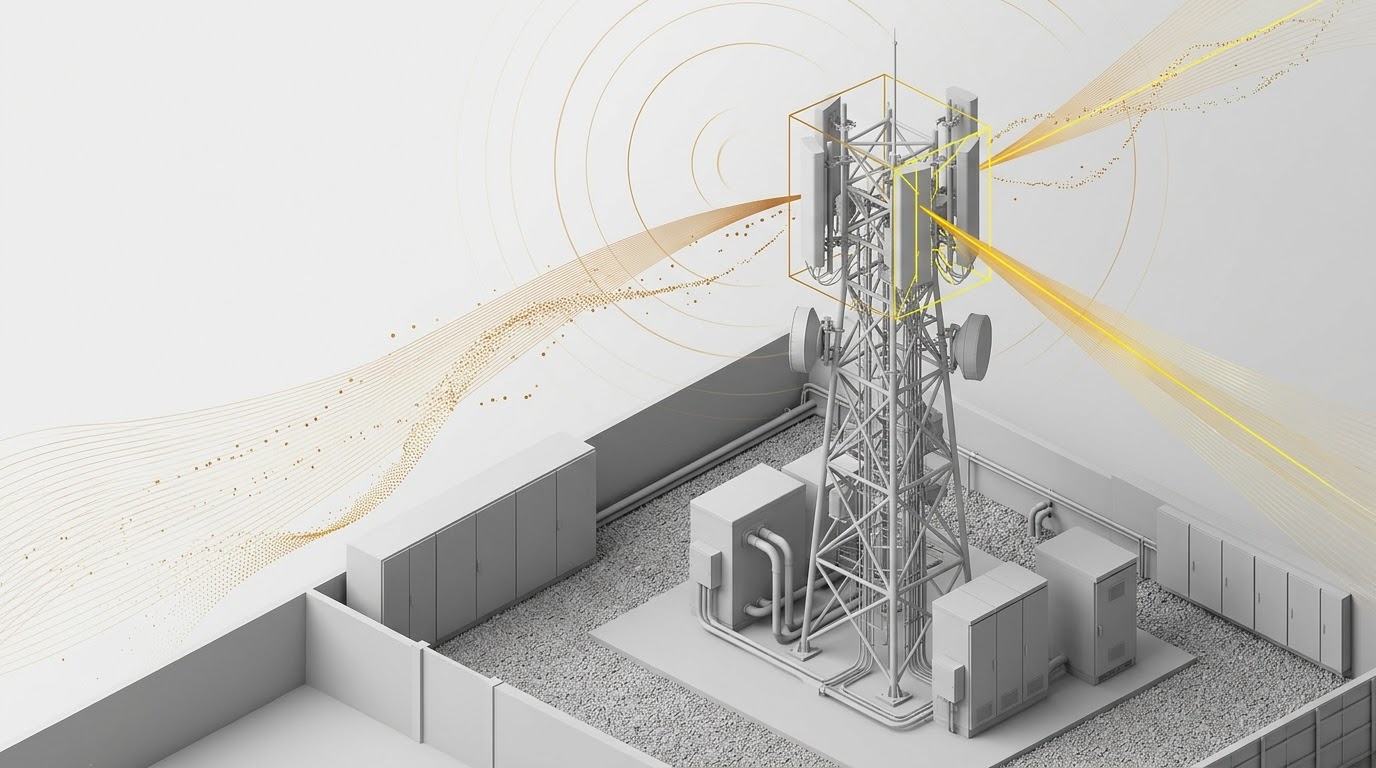
Ingesta en tiempo real de registros de señal (CDR) y telemetría de antenas para detección temprana de incidentes.
Salud y Seguros
Centralización de historiales y reclamos
Integración de datos médicos, admisiones y pólizas con estricto cumplimiento de privacidad y cifrado.
Formatos Abiertos
Apache Iceberg y Delta Lake
Garantía de rendimiento con transacciones ACID, time travel y sin atadura a un único motor de consulta.
Motores de Cómputo
Snowflake, BigQuery y Databricks
Alineación de pipelines para ejecutar transformaciones en el motor analítico óptimo de su organización.
Streaming Analytics
Kafka, Debezium y Flink
Captura de cambios en bases de datos (CDC) para propagar actualizaciones en milisegundos.
Calidad de Datos
Great Expectations y Soda
Detección y aislamiento proactivo de registros corruptos o incompletos antes de llegar a los reportes.

¿Necesita modernizar sus pipelines y centralizar sus datos?

Conversemos para auditar su arquitectura actual y diseñar un data lake escalable.